Điều gì đã xảy ra với Microsoft 365 trong ba ngày 12–14/11/2026, và doanh nghiệp rút ra được gì?
Trong gần một ngày, hàng triệu người trên thế giới không thể mở hộp thư, gửi email hoặc sử dụng bình thường nhiều dịch vụ quen thuộc của Microsoft. Sự cố không bắt nguồn từ hacker, nhưng lại cho thấy một điều đáng suy nghĩ: một hệ thống có hàng nghìn máy chủ và nhiều lớp dự phòng vẫn có thể gặp lỗi trên diện rộng nếu nhiều điểm yếu xuất hiện cùng lúc.
Bài viết này tổng hợp diễn biến sự cố dựa trên báo cáo sơ bộ ngày 15/11/2026 của Microsoft (Post Incident Report), kết hợp với phản ánh từ người dùng và báo chí quốc tế. Vì đây là báo cáo sơ bộ, một số chi tiết có thể được cập nhật trong báo cáo chính thức sau sự cố.
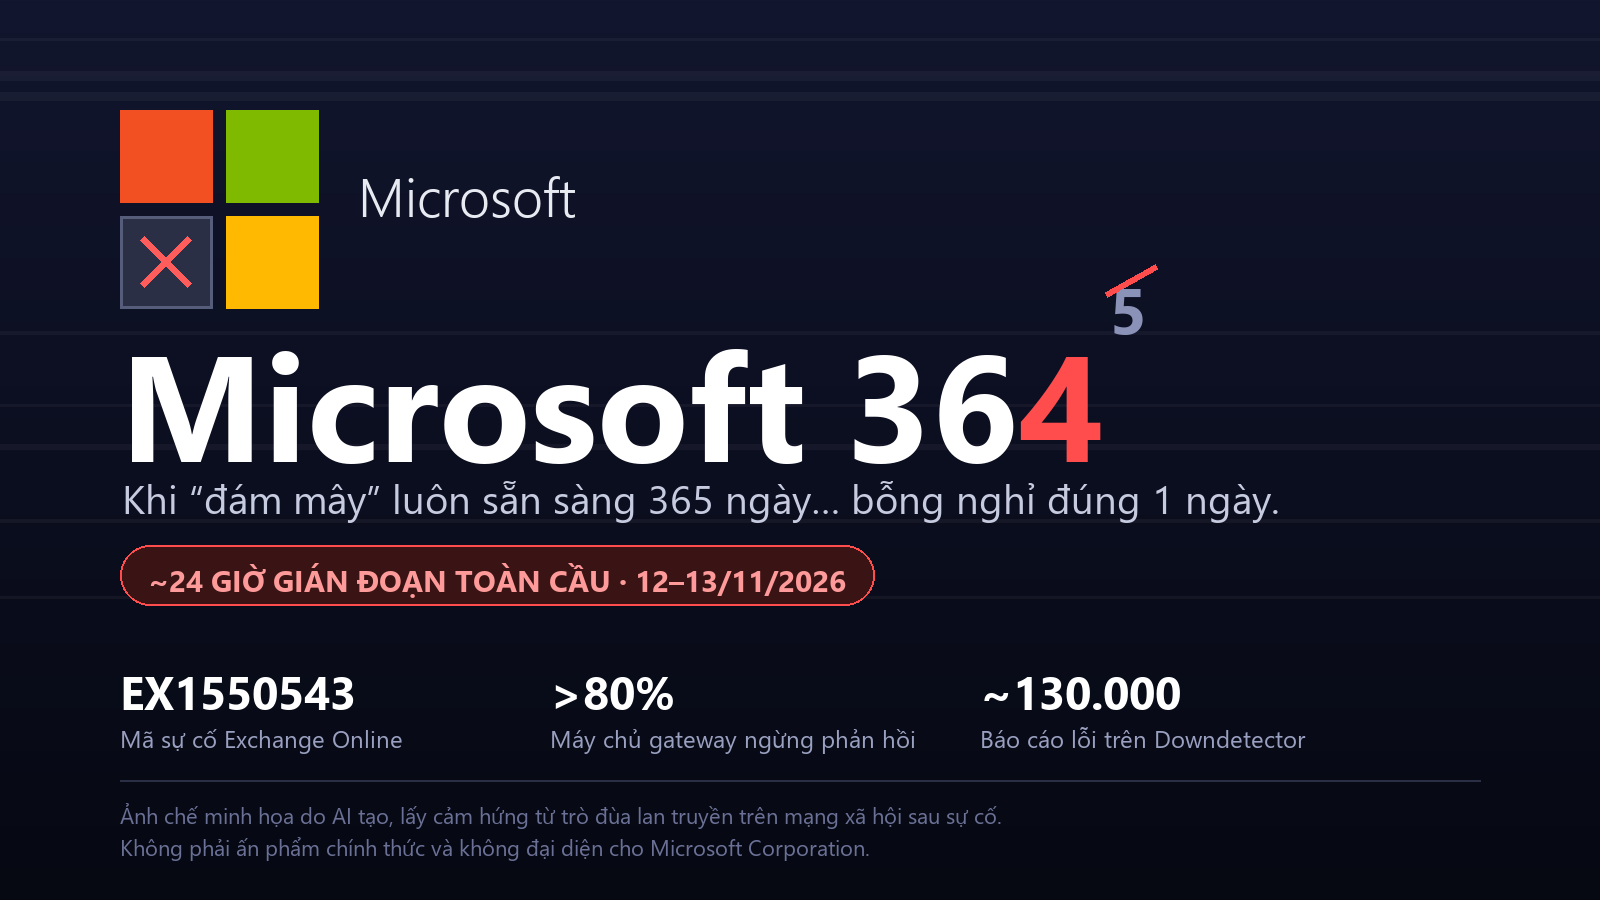
Một ngày thế giới thiếu email Microsoft
Sự cố chính thức bắt đầu lúc 16:20 UTC ngày 12/11/2026, tương đương 23:20 cùng ngày theo giờ Việt Nam.
Dịch vụ bị ảnh hưởng nặng nhất là Exchange Online, nền tảng vận hành email và lịch làm việc trên cloud của Microsoft. Phần lớn người dùng bị ảnh hưởng không thể truy cập hộp thư qua Outlook, Outlook trên trình duyệt, thiết bị di động hoặc các giao diện kết nối khác. Nhiều email gửi đi cũng bị trì hoãn.
Các dịch vụ bị ảnh hưởng trực tiếp hoặc gián tiếp còn bao gồm: Microsoft Teams, Microsoft 365 Copilot, SharePoint, OneDrive, Microsoft Defender, Microsoft Purview, Microsoft Fabric, Microsoft Intune, Microsoft Planner, Power Apps, Microsoft To Do, Power BI và Universal Print.
Không phải tất cả các dịch vụ đều ngừng hoạt động hoàn toàn. Nhiều chức năng của Teams, OneDrive và SharePoint vẫn chạy được, nhưng những phần cần trao đổi dữ liệu với Exchange Online có thể chậm, lỗi hoặc không sử dụng được. Mức độ ảnh hưởng cũng khác nhau tùy quốc gia, khu vực, phương thức kết nối và thời điểm truy cập.
Theo ghi nhận của báo chí, Downdetector nhận được gần 130.000 báo cáo sự cố tại thời điểm cao nhất, đến từ 74 quốc gia. Các cơ quan chính phủ, doanh nghiệp, trường học và dịch vụ công ở nhiều nơi đều báo cáo vấn đề với Outlook và Microsoft 365.
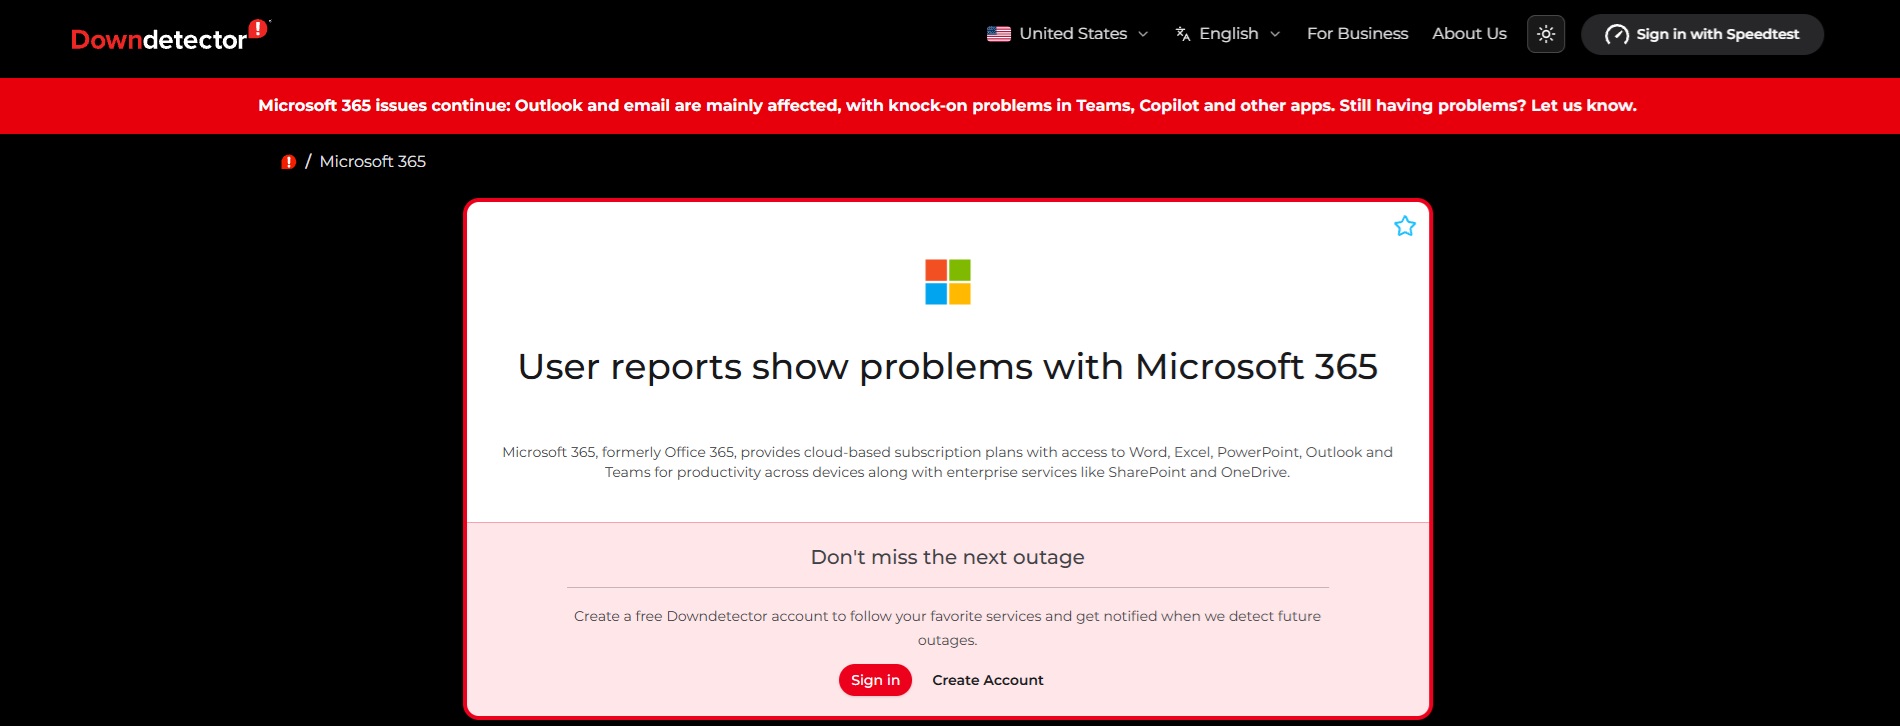
Diễn biến sự cố từ ngày 12 đến 14/11
Trước khi sự cố bùng phát
Điều đáng chú ý là sự cố không bắt đầu bằng một vụ nổ đột ngột. Hệ thống đã âm thầm tích tụ các điều kiện bất lợi từ nhiều giờ trước.
01:07 UTC ngày 12/11 — Khoảng 15 giờ trước thời điểm sự cố chính thức, hệ thống tự động chuyển lưu lượng của Microsoft Teams từ một nhóm network gateway thay thế sang nhóm gateway chính đang phục vụ Exchange Online. Đây vốn là một thao tác bình thường trong kiến trúc dự phòng. Tuy nhiên, việc này làm tải trên nhóm gateway chính tăng dần và thay đổi loại lưu lượng mà các máy chủ phải xử lý.
Từ 01:07 đến 16:00 UTC — Tải trên các máy chủ tăng từ từ. Một số máy chủ tại vài khu vực bắt đầu gặp lỗi riêng lẻ. Hệ thống tự động tiến hành các biện pháp khắc phục thông thường, nhưng chưa nhận ra rằng một sự cố dây chuyền đang hình thành.
Chiều tối ngày 12/11: Sự cố lan rộng
16:03 UTC — Hệ thống giám sát của Microsoft phát hiện số lượng bất thường về lỗi kết nối của người dùng.
16:17 UTC — Cơ chế tự động bắt đầu điều hướng người dùng khỏi những máy chủ có vấn đề sang các máy chủ được xem là còn khỏe. Trong tình huống thông thường, đây là một biện pháp đúng. Nhưng lần này nó vô tình làm sự cố nghiêm trọng hơn.
16:20 UTC — Microsoft nhận cảnh báo ưu tiên cao về tác động tới Exchange Online và đăng thông báo đầu tiên trên Service Health Dashboard với mã sự cố EX1550543. Đây là thời điểm được tính là lúc sự cố chính thức bắt đầu.
16:25–17:45 UTC — Microsoft xác nhận người dùng gặp lỗi qua nhiều phương thức truy cập, bao gồm Outlook, Outlook trên web, Exchange ActiveSync và các API. Các báo cáo của người dùng cũng bắt đầu tăng nhanh trên Downdetector. Trong khi đó, hệ thống tiếp tục chuyển lưu lượng sang những máy chủ còn hoạt động, khiến các máy chủ này phải gánh thêm tải và lần lượt bị quá tải.
18:00–19:00 UTC — Microsoft thử: khởi động lại các máy chủ gặp vấn đề; chuyển lưu lượng sang những phần hạ tầng khác; phân bố lại kết nối; tạm dừng toàn bộ các đợt triển khai và thay đổi cấu hình đang diễn ra hoặc sắp thực hiện. Lúc 18:27 UTC, Microsoft mở thêm thông báo với mã MO1550821, xác nhận sự cố đã ảnh hưởng rộng hơn tới Teams, Copilot, Defender và các dịch vụ Microsoft 365 khác.
19:20 UTC — Các kỹ sư nhận ra hiện tượng tải cao không phải vì số người dùng đột nhiên tăng mạnh. Nguyên nhân là nhiều máy chủ đã ngừng phản hồi, khiến cùng một lượng công việc bị dồn lên số máy chủ ngày càng ít.
20:00–23:55 UTC — Microsoft thử thay đổi health check, khởi động lại máy chủ, chuyển hướng lưu lượng và thiết lập quy trình tự động để phát hiện rồi restart máy chủ bị treo. Nhưng một vấn đề khó xử lý xuất hiện: máy chủ sau khi được khởi động lại có thể hoạt động bình thường trong thời gian ngắn, rồi lại bị quá tải ngay khi nhận lưu lượng thật. Đến 23:55 UTC, Microsoft xác nhận những máy chủ vừa được đưa trở lại hoạt động tiếp tục mất khả năng phản hồi khi người dùng kết nối.
Ngày 13/11: Tìm thấy lỗi và từng bước phục hồi
00:30–01:00 UTC — Đội ngũ kỹ thuật thu hẹp phạm vi điều tra vào quá trình thiết lập kết nối. Họ phát hiện nhiều tiến trình bên trong máy chủ tranh giành nhau một tài nguyên dùng chung, khiến hoạt động thiết lập kết nối bị nghẽn. Nói một cách đơn giản, có thể hình dung hàng trăm người cùng chen qua một cánh cửa hẹp. Càng nhiều người cố đi qua, dòng người càng bị kẹt. Cuối cùng, không ai đi qua được.
01:15–04:00 UTC — Microsoft tiếp tục: giảm áp lực từ hệ thống giám sát; điều chỉnh tải dịch vụ; tắt một số cơ chế tự động chuyển hướng lưu lượng; tăng thêm năng lực hạ tầng; thay đổi giao thức kết nối; phân phối lại lưu lượng; chặn có chọn lọc một số luồng truy cập để bảo vệ hệ thống. Những giải pháp này tạo ra một số dấu hiệu phục hồi, nhưng chưa đủ ổn định.
05:00 UTC — Microsoft tăng quy mô một số máy ảo để bổ sung năng lực xử lý. Tuy nhiên, việc chỉ thêm máy chủ không giải quyết được hoàn toàn vấn đề, vì máy chủ mới vẫn có thể gặp cùng một lỗi phần mềm.
07:20 UTC — Bước ngoặt xuất hiện. Các kỹ sư phát triển một bản cập nhật đưa phần mã xử lý kết nối trở về trạng thái cũ, vốn đã được biết là hoạt động ổn định. Bản sửa được triển khai trước trên một phần hạ tầng.
08:00 UTC — Microsoft xác nhận các máy chủ đã nhận bản sửa hoạt động ổn định. Công ty bắt đầu mở rộng bản cập nhật theo từng khu vực, ưu tiên những nơi đang hoặc sắp bước vào giờ làm việc cao điểm.
10:00–11:35 UTC — Dịch vụ bắt đầu ổn định: khu vực châu Á–Thái Bình Dương dần phục hồi; người dùng truy cập lại được hộp thư; email bắt đầu được xử lý bình thường hơn; châu Âu trở lại trạng thái ổn định vào khoảng 11:35 UTC.
13:00–16:10 UTC — Tình trạng phục hồi được duy trì trên tất cả các khu vực. Hàng đợi email bị chậm bắt đầu giảm. Đến 14:17 UTC, dịch vụ webmail trên toàn cầu đã trở lại mức dự kiến. Lúc 16:10 UTC, Microsoft xác nhận khách hàng không còn chịu ảnh hưởng trực tiếp và chuyển sang giai đoạn giám sát mở rộng, đồng thời xử lý những email còn tồn trong hàng đợi.
Ngày 14/11: Xác nhận sự cố đã kết thúc
Lúc 04:15 UTC ngày 14/11, sau khoảng 12 giờ theo dõi thêm, Microsoft xác nhận hệ thống tiếp tục ổn định và phát hành thông báo cuối cùng cho hai sự cố EX1550543 và MO1550821.
Như vậy: thời gian người dùng chịu ảnh hưởng trực tiếp được Microsoft ghi nhận là từ 16:20 UTC ngày 12/11 đến 16:10 UTC ngày 13/11 — gần 24 giờ. Đến sáng 14/11, sau giai đoạn giám sát kéo dài, Microsoft mới chính thức đóng thông báo sự cố.
Nguyên nhân sâu xa: Không phải một lỗi, mà là nhiều lỗi gặp nhau
Một sự cố lớn hiếm khi chỉ có một nguyên nhân. Trong trường hợp này, ba yếu tố chính cùng xuất hiện và tạo ra một “cơn bão hoàn hảo”.
Nguyên nhân thứ nhất: Một lỗi phần mềm đã ẩn mình từ tháng 7
Từ tháng 7/2026, Microsoft đã triển khai một thay đổi dành riêng cho các máy chủ network gateway của Microsoft 365. Network gateway có thể hiểu đơn giản là “cổng giao thông” đứng trước các dịch vụ: yêu cầu của người dùng phải đi qua đó trước khi đến được email, dữ liệu hoặc ứng dụng phía sau.
Thay đổi này chứa một lỗi tiềm ẩn gây ra tình trạng tranh chấp tài nguyên (contention issue) — hay còn gọi là lock contention, tức nhiều tiến trình cùng tranh giành quyền truy cập một tài nguyên nội bộ. Khi gặp điều kiện tải nhất định, CPU và bộ nhớ bị sử dụng cạn kiệt, khiến máy chủ ngừng phản hồi.
Lỗi không xuất hiện ngay. Bản cập nhật đã hoạt động trên toàn cầu hơn ba tháng mà không gây ra sự cố rõ ràng.
Vì sao kiểm thử không phát hiện được? Môi trường kiểm thử của Microsoft chưa mô phỏng đúng tổ hợp xảy ra trong thực tế: loại lưu lượng thử nghiệm khác lưu lượng thật; cấu hình máy chủ trong phòng lab khác môi trường production; kiểm thử chủ yếu dùng phần cứng yếu hơn và ít CPU core hơn — trong khi lỗi lại trở nên nghiêm trọng hơn trên phần cứng mới, có nhiều core hơn.
Đây là một nghịch lý đáng chú ý: máy chủ mạnh hơn không phải lúc nào cũng ít lỗi hơn. Với một số lỗi đồng thời, nhiều CPU core có thể làm nhiều tiến trình tranh giành tài nguyên mạnh hơn.
Nguyên nhân thứ hai: Lưu lượng Teams được chuyển sang gateway chính
Khoảng 15 giờ trước sự cố, Teams tự động failover sang hệ thống gateway chính đang phục vụ Exchange Online. Failover nghĩa là chuyển hoạt động từ một hệ thống sang hệ thống khác khi cần — đây là tính năng dự phòng bình thường, không phải thao tác bất thường.
Tuy nhiên, việc chuyển Teams đã: làm tải trên gateway chính tăng lên; thay đổi cấu trúc lưu lượng; làm tăng xác suất kích hoạt lỗi lock contention đã tồn tại từ tháng 7.
Nguyên nhân thứ ba: 14% năng lực máy chủ gateway đang không hoạt động
Cùng thời điểm đó, khoảng 14% năng lực máy chủ gateway đang tạm thời không hoạt động do một vấn đề không liên quan xảy ra từ ngày trước.
Nếu chỉ xảy ra riêng lẻ, mức thiếu hụt này chưa đủ gây sự cố — hệ thống vẫn còn khả năng dự phòng. Nhưng khi 14% năng lực bị thiếu, Teams chuyển thêm lưu lượng sang và lỗi phần mềm bắt đầu xuất hiện, các máy chủ còn lại nhanh chóng phải chịu áp lực quá lớn.
Tại sao sự cố lại lan ra toàn cầu?
Khi một máy chủ ngừng phản hồi, hệ thống quản lý lưu lượng sẽ chuyển người dùng sang một máy chủ còn khỏe. Thông thường, cơ chế này giúp người dùng không nhận ra rằng một máy chủ vừa hỏng. Nhưng trong sự cố này, các máy chủ “khỏe” cũng chứa cùng một lỗi phần mềm.
Chuỗi sự kiện diễn ra như sau: một số máy chủ bị quá tải và ngừng phản hồi → người dùng được chuyển sang những máy chủ còn lại → các máy chủ còn lại nhận thêm lưu lượng → tải cao kích hoạt cùng lỗi phần mềm → những máy chủ này tiếp tục ngừng phản hồi → lưu lượng lại bị chuyển sang số máy chủ ngày càng ít hơn → toàn bộ hệ thống rơi vào lỗi dây chuyền.
Trong chưa đầy hai giờ, hơn 80% số máy chủ gateway đã mất khả năng phản hồi. Hiện tượng này được gọi là cascading failure, hay lỗi dây chuyền.
Đáng lẽ, các khu vực và nhóm năng lực phải được ngăn cách bằng những “vách ngăn” kỹ thuật. Tuy nhiên, theo báo cáo sơ bộ, một vấn đề khác khiến các vách ngăn này không chặn được sự lan truyền. Vì thế, sự cố không dừng lại trong một nhóm máy chủ hay một khu vực mà lan ra hạ tầng toàn cầu.
Vì sao việc khôi phục mất nhiều thời gian?
Máy chủ vừa hoạt động lại đã bị quá tải. Hàng triệu yêu cầu đang chờ sẵn. Khi một nhóm máy chủ được đưa trở lại, lượng lớn yêu cầu lập tức đổ vào. Máy chủ chưa kịp ổn định đã lại gặp cùng lỗi.
Hệ thống tự động không được thiết kế cho tình trạng này. Các công cụ phục hồi tự động của Microsoft có thể xử lý một số máy chủ hoặc một khu vực gặp lỗi. Nhưng lần này, hơn 80% máy chủ cùng mất khả năng phản hồi — một trạng thái quá rộng so với kịch bản phục hồi tự động thông thường.
Không thể rollback nhanh theo cách thông thường. Nếu một bản cập nhật mới gây lỗi ngay sau khi triển khai, đội kỹ thuật có thể rollback, tức quay lại phiên bản trước. Nhưng lỗi trong sự cố này đã được triển khai từ tháng 7 và hoạt động bình thường trong hơn ba tháng. Vì thế: hệ thống không thể dễ dàng xác định thay đổi gần nhất cần quay lại; feature flag thông thường không còn hữu dụng; rollback tự động không được kích hoạt; kỹ sư phải điều tra và xây dựng một bản sửa riêng.
Microsoft đã làm gì để xử lý sự cố?
Microsoft áp dụng nhiều biện pháp trong quá trình điều tra và phục hồi:
- Chuyển hướng và phân phối lại lưu lượng — cố gắng chuyển người dùng khỏi những máy chủ bị lỗi; khi nhận ra việc chuyển hướng tự động có thể làm sự cố dây chuyền nghiêm trọng hơn, công ty đã tắt một số cơ chế tự động này.
- Khởi động lại các máy chủ bị treo — chỉ mang lại hiệu quả tạm thời vì lỗi xuất hiện trở lại khi lưu lượng thực tế quay về.
- Tạm dừng deployment và thay đổi cấu hình — từ 19:00 UTC ngày 12/11, giúp tránh tạo thêm biến số khi nhóm kỹ thuật còn chưa biết nguyên nhân chính xác.
- Điều chỉnh health check — tránh việc một thành phần kiểm tra lỗi tiếp tục loại máy chủ khỏi hệ thống một cách không cần thiết.
- Giảm tải có chọn lọc — điều chỉnh giám sát, giao thức, luồng kết nối; chặn có chọn lọc một số luồng để giảm áp lực lên hạ tầng đang phục hồi.
- Bổ sung năng lực máy chủ — tăng quy mô máy ảo; không tự sửa được lỗi phần mềm, nhưng cho quá trình phục hồi thêm khoảng trống an toàn hơn.
- Đưa mã xử lý kết nối trở về trạng thái ổn định cũ — giải pháp quan trọng nhất. Microsoft đưa từng nhóm máy chủ ra khỏi hệ thống, cài bản sửa, restart rồi mới đưa chúng trở lại phục vụ người dùng, triển khai theo từng cụm lớn (có lúc hơn 50% hạ tầng một khu vực) nhưng vẫn kiểm soát chặt để tránh thêm một đợt quá tải mới.
- Kéo dài thời gian lưu email — mở rộng cửa sổ chuyển phát để thư bị trì hoãn không bị trả lại dưới dạng “không thể gửi”.
- Tăng cường giám sát và đặt thêm guardrail — bổ sung giám sát mẫu chuyển hướng lưu lượng, giám sát sức khỏe quá trình xử lý kết nối, giới hạn bảo vệ phân phối traffic, và cơ chế ngăn một lỗi cục bộ tạo thành sự cố dây chuyền.
Microsoft đã xử lý truyền thông khủng hoảng như thế nào?
Trong giai đoạn đầu, Microsoft thông báo qua Service Health Dashboard và mở hai mã sự cố riêng: EX1550543 cho Exchange Online, MO1550821 cho phạm vi Microsoft 365 rộng hơn.
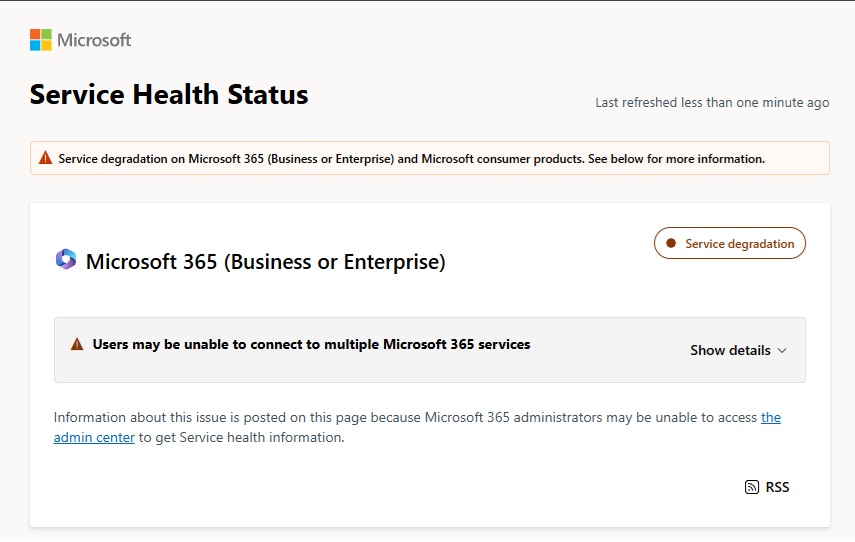
Microsoft liên tục cập nhật về: phạm vi ảnh hưởng; tình trạng các khu vực; những biện pháp đang được thử nghiệm; tiến độ xử lý hàng đợi email; thời điểm dịch vụ dần phục hồi.
Trên mạng xã hội X, ông Charles Lamanna — Phó Chủ tịch điều hành (EVP) phụ trách Copilot, Agents and Platform của Microsoft — công khai xin lỗi, cho biết ông “deeply sorry” về sự gián đoạn đối với khách hàng và đối tác. Qua các kênh truyền thông, đại diện Microsoft cũng khẳng định đây là sự cố kỹ thuật, không phải tấn công mạng và không do AI agent gây ra.
Một điểm tích cực là Microsoft không tuyên bố “đã khắc phục hoàn toàn” ngay khi thấy một số dấu hiệu cải thiện. Dịch vụ được đưa trở lại theo từng bước và tiếp tục được giám sát trong khoảng 12 giờ trước khi thông báo cuối cùng được phát hành.
Tuy nhiên, phản ứng của cộng đồng cũng cho thấy một hạn chế: khi Outlook, Teams và Service Health cùng nằm trong hệ sinh thái Microsoft, doanh nghiệp có thể gặp khó khăn trong việc nhận thông tin và liên lạc nội bộ ngay tại thời điểm cần nhất.
Những bài học dành cho doanh nghiệp sử dụng dịch vụ Microsoft
Sự cố không có nghĩa là doanh nghiệp nên ngừng sử dụng cloud hoặc quay toàn bộ hệ thống về on-premise. Nhưng nó cho thấy không nên đặt mọi hoạt động quan trọng vào một hệ sinh thái mà không chuẩn bị phương án thay thế.
Bài học 1: Cloud không đồng nghĩa với “không bao giờ hỏng”
Một công ty công nghệ rất lớn vẫn có thể gặp sự cố dài gần 24 giờ. Hàng nghìn máy chủ và nhiều khu vực địa lý không thể ngăn được lỗi nếu tất cả cùng phụ thuộc vào một phần mềm hoặc một cơ chế quản lý chung. Doanh nghiệp cần nhìn cloud như một nền tảng có độ tin cậy cao, không phải một nền tảng bất khả chiến bại.
Bài học 2: Dự phòng phải tránh cùng một nguyên nhân gây lỗi
Có nhiều máy chủ chưa chắc đã đủ nếu tất cả máy chủ: chạy cùng một phiên bản lỗi; dùng chung gateway; phụ thuộc cùng một hệ thống danh tính; được cấu hình bằng cùng một quy trình tự động; bị điều khiển bởi cùng một control plane. Đây gọi là common-mode failure, tức nhiều thành phần dự phòng cùng hỏng vì một nguyên nhân chung.
Khi thiết kế hệ thống quan trọng, doanh nghiệp cần đặt câu hỏi: “Nếu thành phần dùng chung này bị lỗi, các hệ thống dự phòng còn hoạt động được không?”
Bài học 3: Phải có kênh liên lạc ngoài Microsoft 365
Nếu email, Teams, SharePoint, danh bạ và tài liệu xử lý sự cố đều nằm trong Microsoft 365, nhân viên có thể không truy cập được chính những thông tin cần thiết khi Microsoft gặp sự cố.
Doanh nghiệp nên có một kênh khẩn cấp độc lập, chẳng hạn: nhóm WhatsApp hoặc Signal giới hạn cho đội xử lý khủng hoảng; SMS hoặc điện thoại; danh sách liên hệ được mã hóa và lưu offline; một trang thông báo trạng thái nằm ngoài Microsoft 365; bản sao offline của incident response playbook. Kênh thay thế chỉ nên dùng trong tình huống khẩn cấp và phải được quản lý theo chính sách bảo mật của doanh nghiệp.
Bài học 4: Xây dựng Microsoft 365 Outage Playbook
Doanh nghiệp nên có một tài liệu ngắn, dễ thực hiện, quy định rõ:
- Trong 15 phút đầu: kiểm tra tình trạng mạng nội bộ và Internet; kiểm tra DNS và hệ thống định danh; xem Microsoft 365 Service Health; xác định đó là lỗi riêng của công ty hay lỗi từ Microsoft.
- Sau 30 phút: chỉ định Incident Manager; mở phòng xử lý sự cố qua kênh độc lập; thông báo cho Service Desk và lãnh đạo; ngăn nhân viên mất thời gian cài lại Outlook hoặc đổi mật khẩu không cần thiết.
- Sau 60 phút: kích hoạt phương án làm việc thủ công; chuyển các phê duyệt khẩn cấp sang quy trình dự phòng; thông báo cho khách hàng hoặc đối tác nếu dịch vụ bị ảnh hưởng; ghi nhận các quyết định để bổ sung audit trail sau sự cố.
- Sau 4 giờ: đánh giá ảnh hưởng đến hoạt động kinh doanh; xác định nghĩa vụ thông báo theo hợp đồng hoặc quy định; cập nhật cho lãnh đạo theo chu kỳ cố định; chuẩn bị phương án vận hành nếu sự cố kéo dài qua ngày làm việc tiếp theo.
Bài học 5: Không nhầm replication với backup
Sự cố Microsoft 365 lần này không làm mất hay sai lệch dữ liệu, nhưng vẫn là lời nhắc để doanh nghiệp rà soát lại chiến lược dự phòng dữ liệu của mình. Đồng bộ dữ liệu sang nhiều máy chủ không thay thế được backup — nếu một lỗi phần mềm, thao tác xóa nhầm hay ransomware tác động đến dữ liệu, nội dung sai có thể được đồng bộ đến tất cả các bản sao.
Doanh nghiệp cần: backup tách biệt khỏi môi trường vận hành; bật versioning và retention; sử dụng immutable backup cho dữ liệu quan trọng; bảo vệ tài khoản backup bằng MFA; kiểm thử restore định kỳ, không chỉ kiểm tra rằng backup job báo “thành công”.
Bài học 6: Đo trải nghiệm thực tế, không chỉ nhìn dashboard
Dashboard của nhà cung cấp rất cần thiết nhưng không phải lúc nào cũng phát hiện sự cố trước người dùng. Trong sự cố này, phản ánh từ khách hàng và Downdetector tăng nhanh cùng lúc Microsoft đang điều tra dữ liệu nội bộ.
Doanh nghiệp nên theo dõi các giao dịch thực tế, ví dụ: người dùng có đăng nhập được không; email thử nghiệm có gửi và nhận được không; API có trả về kết quả không; trang ứng dụng có mở được từ địa điểm của doanh nghiệp không; thời gian phản hồi có tăng bất thường không. Các công cụ như Azure Monitor, Application Insights, ThousandEyes, Datadog hoặc Dynatrace có thể giúp theo dõi trải nghiệm từ phía doanh nghiệp, thay vì chỉ phụ thuộc vào trạng thái do nhà cung cấp công bố.
Bài học 7: Giữ một lớp vận hành cục bộ khi cần thiết
Không nhất thiết phải đưa Exchange hoặc Teams trở lại on-premise. Tuy nhiên, một số hệ thống tại văn phòng vẫn cần khả năng hoạt động khi Internet hoặc cloud gặp vấn đề, ví dụ: router, firewall và Wi-Fi; hệ thống kiểm soát cửa; CCTV và báo động; máy in hoặc thiết bị tại chỗ; danh sách liên hệ khẩn cấp; tài khoản quản trị break-glass; bản sao cấu hình thiết bị.
Chiến lược phù hợp không phải “cloud hay on-premise”, mà là: cloud-first cho ứng dụng doanh nghiệp, nhưng vẫn duy trì khả năng sống sót cục bộ cho những dịch vụ thật sự cần thiết.
Kết luận: Bài học không phải là rời bỏ cloud
Sự cố Microsoft 365 từ ngày 12 đến 14/11/2026 không phải do hacker, cũng không đơn giản chỉ là “máy chủ quá tải”. Nguyên nhân thực sự là sự kết hợp của ba yếu tố: một lỗi phần mềm tiềm ẩn từ tháng 7; lưu lượng Teams được chuyển vào gateway chính; và khoảng 14% năng lực máy chủ gateway đang tạm thời không hoạt động.
Khi một số máy chủ gặp lỗi, cơ chế tự động chuyển lưu lượng sang các máy còn lại. Vì các máy chủ còn lại có cùng lỗi phần mềm, chúng tiếp tục bị quá tải và tạo thành lỗi dây chuyền. Ở thời điểm nghiêm trọng nhất, hơn 80% máy chủ gateway không phản hồi. Microsoft cuối cùng khôi phục được dịch vụ bằng cách đưa mã xử lý kết nối trở lại phiên bản ổn định, bổ sung capacity, kiểm soát lưu lượng, xử lý hàng đợi email và tăng cường các cơ chế bảo vệ chống lỗi dây chuyền.
Bài học quan trọng nhất đối với doanh nghiệp không phải là ngừng sử dụng Microsoft hay quay hoàn toàn về on-premise. Thay vào đó, doanh nghiệp cần chấp nhận một thực tế: không có nền tảng nào hoàn toàn không gặp sự cố. Một doanh nghiệp có khả năng phục hồi tốt không phải là doanh nghiệp không bao giờ bị gián đoạn, mà là doanh nghiệp vẫn biết cách liên lạc, ra quyết định và tiếp tục những hoạt động quan trọng khi nền tảng chính tạm thời không hoạt động.